データ連携とは? 仕組み・方法・メリットから、ツールによる実践まで~企業内外のデータをつなぎ、業務自動化とデータ活用を支える連携基盤~
「販売管理システムの実績を毎日CSVで出力し、Excelで加工して会計システムへ取り込む」「SaaSに登録した顧客情報を、基幹システムへもう一度入力する」。
こうした作業が当たり前になっていないでしょうか。
企業では、基幹システム、CRM、SFA、会計、人事、EC、BI、クラウドストレージなど、用途の異なるシステムが使われています。しかし、それぞれが独立していると、同じ情報の二重入力、データの不整合、集計の遅れ、担当者への属人化が発生します。
そこで必要になるのが「データ連携」です。
本記事では、データ連携の意味や仕組みを初めて調べる方にもわかるように、API連携、ファイル連携、データベース連携、ETL、EAI、iPaaSなどの違いを整理します。さらに、ノーコードのデータ連携ツールを使って、複数システムの連携を効率化・標準化する考え方と実践例まで詳しく解説します。
目次[非表示]
- 1.データ連携とは
- 1.1.身近なデータ連携の例
- 1.2.データ連携と似た用語の違い
- 2.なぜ今、データ連携が重要なのか
- 2.1.二重入力と転記作業が増える
- 2.2.データの整合性が取れない
- 2.3.集計と意思決定が遅れる
- 2.4.業務が属人化する
- 2.5.連携プログラムが複雑化する
- 3.データ連携の基本的な仕組み
- 3.1.リアルタイム連携とバッチ連携
- 4.データ連携の主な方法
- 4.1.API連携
- 4.2.ファイル連携
- 4.3.データベース連携
- 4.4.Webhook・メッセージ連携
- 4.5.RPAによる画面連携
- 5.ETL・EAI・iPaaS・EDIの違い
- 6.自社に合うデータ連携基盤を選ぶための整理
- 6.1.連携要件を整理する
- 6.2.個別開発か共通基盤かを判断する
- 7.ASTERIA Warpとは
- 8.【実践】ASTERIA WarpでCSVをSalesforceへ連携してみる
- 9.まとめ:データ連携を「個別対応」から「共通基盤」へ
データ連携とは
データ連携とは、異なるシステム、アプリケーション、データベース、ファイルなどの間でデータを受け渡し、共有・活用できる状態にする仕組みやプロセスです。単にデータを移動するだけではありません。連携元から取得したデータを、連携先が扱える形式に変換し、必要なタイミングで登録し、処理結果を監視するところまで含みます。
ひと言で表すと、データ連携は「必要なデータを、必要な形に整え、必要なタイミングで、必要な場所へ届ける仕組み」です。
身近なデータ連携の例
データ連携は、大規模な基幹システムだけの話ではありません。日常的なコピー&ペーストやCSVの受け渡しも、広い意味ではデータ連携です。ただし、人が毎回操作する方法は、件数が増えるほど時間とミスが増えやすくなります。
身近なデータ連携の例としてこのようなものがあります。
- ECサイトの注文情報を在庫管理システムへ登録する
- Salesforceの受注情報を基幹システムへ連携する
- 人事マスタの社員情報をMicrosoft 365や各業務システムへ反映する
- 会計システムの実績をDWHへ集約し、BIで可視化する
- 取引先から受け取った受注ファイルを変換し、販売管理システムへ取り込む
データ連携と似た用語の違い
データ連携のほかに似た用語がいくつかあります。
システム連携、データ統合、データ移行との違いを見てみましょう。
用語 | 焦点 | 具体例 |
データ連携 | データの取得・変換・受け渡し | 顧客情報をCRMから基幹システムへ同期 |
システム連携 | 認証や処理実行を含むシステム間協調 | 受注確定を契機に在庫引当と請求処理を実行 |
データ統合 | 分散データを統一された状態にまとめる | 顧客データを名寄せして統合顧客IDを作成 |
データ移行 | 旧環境から新環境への一時的な移し替え | 基幹刷新時に旧DBから新DBへ移行 |
なぜ今、データ連携が重要なのか
クラウドサービスやSaaSの普及により、企業が利用するシステムが増える一方、データが部門やシステムごとに分散する「データのサイロ化」が課題となっています。データが分断されたままでは、二重入力や転記作業、情報の不整合、集計の遅れなどが生じ、業務効率や意思決定に影響します。また、AIやBIの活用においても、元となるデータの品質や鮮度が十分でなければ、分析結果の信頼性を高めることはできません。
業務を効率化し、組織全体でデータを活用できる環境を整えるためにも、分散したデータを継続的かつ安全につなぐ仕組みが重要です。
二重入力と転記作業が増える
同じ顧客、商品、受注、請求などの情報を複数システムへ入力すると、作業時間が増えます。入力先が増えるほど、入力漏れやタイプミスも発生しやすくなります。
データの整合性が取れない
あるシステムでは住所が更新され、別のシステムでは旧住所のままという状態が起こります。在庫数や価格など業務判断に直結するデータがずれると、誤受注や誤請求につながります。
集計と意思決定が遅れる
月末に複数部門からファイルを集め、Excelで集計している場合、経営層が結果を確認できるのは数日後になります。継続的な自動連携があれば、より新しい情報で判断できます。
業務が属人化する
マクロ、スクリプト、手作業の手順が特定担当者しか理解していないと、異動や退職によって処理を継続できなくなる可能性があります。
連携プログラムが複雑化する
システムごとに個別の連携プログラムを作ると、接続先の増加に伴って保守対象が増えます。仕様変更の影響範囲を把握しにくくなり、改修コストも高くなります。
データ連携の基本的な仕組み
データ連携の処理は、一般に「取得」「変換」「登録」「監視」の4段階で考えると理解しやすくなります。実際のプロジェクトでは、認証、排他制御、重複防止、エラー時の再実行なども設計します。
工程 | 主な処理 | 設計上の確認点 |
1. 取得 | API、ファイル、DBなどからデータを読み込む | 全件か差分か、取得頻度、認証方式 |
2. 変換 | 項目マッピング、型変換、コード変換、マスタ変換など | 必須項目、文字コード、日付・数値形式 |
3. 登録 | 連携先へ新規登録または更新する | 一意キー、重複防止、トランザクション |
4. 監視 | ログ、通知、リトライ、処理件数確認 | 通知先、再実行単位、ログ保管期間 |
リアルタイム連携とバッチ連携
データ連携には、大きく「リアルタイム連携」と「バッチ連携」の2つの方式があります。
リアルタイム連携は、データの更新やイベント発生時に即座に情報を反映できるため、在庫管理や受注処理、顧客対応など最新情報が求められる業務に適しています。
一方、バッチ連携は指定した時刻や一定間隔でまとめて処理を行う方式で、大量データの集計や分析、マスタ配信などに適しています。
求められる鮮度や処理量、システム負荷を踏まえ、業務要件に応じて使い分けることが重要です。
比較項目 | リアルタイム連携 | バッチ連携 |
実行契機 | データ更新やイベント発生時 | 指定時刻・一定間隔 |
適する業務 | 在庫、受注、顧客対応、通知 | 日次集計、マスタ配信、分析 |
長所 | 情報の鮮度が高い | 大量データをまとめて処理しやすい |
注意点 | 障害時の影響や負荷を考慮 | 処理時間と締め時間を考慮 |
データ連携の主な方法
データ連携にはさまざまな方式があり、求められるリアルタイム性やデータ量、接続先システムの特性によって適した手法は異なります。近年はSaaSやクラウドサービスの普及によりAPI連携が主流になりつつありますが、基幹システムとの接続ではファイル連携やデータベース連携が活用されるケースも少なくありません。それぞれの特徴や注意点を理解し、自社の要件に合った方式を選択することが、安定したデータ連携を実現するうえで重要です。
方式 | リアルタイム性 | 大量処理 | 既存システム対応 | 主な注意点 |
API | 高 | 中 | APIの有無に依存 | 認証、制限、仕様変更 |
ファイル | 低〜中 | 高 | ファイルに出力可能であれば対応可能 | 重複、文字コード、送受信管理 |
DB | 中〜高 | 高 | DB公開範囲に依存 | 負荷、権限、整合性 |
Webhook | 高 | 中 | 対応製品に依存 | 再送、重複、順序 |
RPA | 中 | 低〜中 | 画面操作できれば対応可能 | 画面変更、安定性 |
API連携
API連携は、システムが公開するAPIを介してデータを取得・登録する方法です。Web APIではREST形式が多く、JSONなどでデータを受け渡します。リアルタイム性や双方向性が必要な場合に有力ですが、認証、APIの呼び出し上限、タイムアウト、仕様変更、エラー応答への対応が必要です。
向いている例:SaaS間連携、受注・在庫の即時同期、モバイルアプリとの連携
確認点:Basic/OAuthなどの認証、レート制限、ページング、エラー時の再送や二重登録の防止
ファイル連携
CSV、Excel、固定長、XML、JSONなどのファイルを介する方法です。古い基幹システムや企業間連携でも利用しやすく、定時バッチに向きます。一方、ファイル名、配置先、文字コード、改行コード、重複受信、途中ファイルの読込みを防ぐ仕組みが必要です。
データベース連携
データベースへ接続し、SQLなどでデータを取得・更新する方法です。大量データを効率的に扱えますが、業務システムのDBへ直接書き込むと整合性を壊す可能性があります。原則として製品の公開仕様や推奨インターフェースを確認し、負荷と権限を最小化します。
Webhook・メッセージ連携
Webhookは、システム上のイベント発生時に指定先へ通知する方式です。また、メッセージキューを介して送信側と受信側を疎結合にする設計もあります。リアルタイム性や耐障害性に優れますが、再送、重複、順序性、未処理メッセージの監視が重要です。
RPAによる画面連携
APIやファイル出力がない場合、RPAで画面操作を自動化する選択肢があります。短期間で開始しやすい一方、画面レイアウトや表示速度の変更に影響されやすいため、安定したデータ連携にはAPIやファイル連携を優先し、RPAは補完手段として検討します。
ETL・EAI・iPaaS・EDIの違い
APIやファイルは「接続方式」、ETLやEAIは「目的や機能で分類したツールカテゴリ」です。両者を混同しないことが重要です。例えばEAI製品が、API、ファイル、DBという複数の接続方式を一つの基盤で扱うことがあります。
種類 | 主な目的 | 得意領域 | 代表的な利用場面 |
ETL | 抽出・変換・格納 | 大量データの加工と集約 | DWH、BI、データ分析 |
EAI | 企業内アプリケーション統合 | 業務システム間の制御・変換 | 基幹、会計、CRM、SaaS連携 |
iPaaS | クラウド上の統合サービス | SaaSやクラウド連携 | クラウド中心の統合、自動化 |
EDI | 企業間の電子データ交換 | 受発注・出荷・請求 | 取引先とのデータ交換 |
RPA | 人の画面操作の代替 | 入力・転記・定型操作 | APIがない画面業務 |
選び方の基本
大量データを分析基盤へ集めるならETL、複数の業務システムを継続的に連携するならEAI、クラウド中心ならiPaaS、企業間取引ならEDIが候補です。ただし、製品によって機能範囲は重なります。名称だけでなく、必要な接続先、処理量、リアルタイム性、運用機能で評価します。
自社に合うデータ連携基盤を選ぶための整理
データ連携の方式や製品は数多く存在するため、「どのツールが優れているか」ではなく、「自社の課題や要件に合っているか」という視点で選定することが重要です。連携先の数やシステム構成、求められるリアルタイム性、運用体制によって最適な選択肢は変わります。
ここでは、データ連携基盤を選定する際に押さえておきたい考え方と判断ポイントを整理します。
連携要件を整理する
ここまで見てきたように、データ連携にはAPI、ファイル、データベースなど複数の接続方式があり、それらを実現する製品カテゴリにもETL、EAI、iPaaSなどの違いがあります。実際の導入では、名称や機能の多さだけで選ぶのではなく、連携元・連携先、実行タイミング、データ量、変換の複雑さ、エラー時の再実行、監視方法といった要件を整理することが出発点です。要件を明確にすることで、個別開発で対応できる範囲と、連携基盤として共通化すべき範囲を判断しやすくなります。
個別開発か共通基盤かを判断する
連携先が少なく、仕様変更もほとんどない場合は、個別プログラムでの対応が適することもあります。一方、接続先や処理が増え続ける環境では、開発方法や運用ルールがばらばらになり、保守や障害対応が複雑になりがちです。そのため、複数の接続方式を扱えることに加え、変換処理の再利用、処理状況の可視化、ログ・通知・再実行、権限管理まで一つの仕組みで標準化できるかが、連携基盤を選ぶ重要な判断軸になります。
次章では、こうした要件に対応し、個々の連携を共通基盤へまとめる選択肢として、ASTERIA Warpの特長と適する場面を紹介します。
ASTERIA Warpとは
ASTERIA Warpは、アステリア株式会社が提供するデータ連携基盤です。基幹システム、データベース、ファイル、クラウドサービス、SaaSなどをノーコードでつなぎ、データの取得、変換、登録、通知、監視をフローとして設計できます。100種類以上の接続先、10,000社以上の導入実績、クラウドとオンプレミスをまたいだ連携への対応が特長です。
ASTERIA Warpの位置付け
個々のシステム間に連携プログラムを追加し続けるのではなく、連携処理を共通基盤へ集約し、開発・運用・監視を標準化するための選択肢です。
ASTERIA Warpが適する場面
ASTERIA Warpは、CSVやExcelを用いた手作業によるデータ連携を自動化したい場合や、システム間連携のための個別開発が増加している場合に適しています。また、オンプレミス環境とクラウドサービスが混在するシステム環境において、連携処理を標準化・内製化したい企業にも有効です。
個別プログラムによる連携を増やし続けるのではなく、データ連携基盤を統一することで、保守性や可視性の向上、運用負荷の軽減が期待できます。また、ノーコードで連携フローを開発できるため、開発・運用の属人化を防ぎやすい点も特長です。
さらに、URLトリガー、FTPトリガー、スケジュールトリガー、メールトリガーなど多様な起動方式を備えており、リアルタイム連携から定期バッチ処理まで幅広い業務要件に対応できます。
また、ASTERIA WarpはETL/EAIツールとして、大量データの集約・加工・連携だけでなく、ERP、CRM、SFA、基幹システムなど異なる業務システム間のデータ連携基盤としても活用されています。
【実践】ASTERIA WarpでCSVをSalesforceへ連携してみる
ここでは、身近な例として「共有フォルダに置かれたCSVファイルを読み込み、項目を変換してSalesforceの取引先情報へ登録する」流れを考えます。実際の環境では、認証方式、項目定義、重複判定、エラー時の通知方法を確認したうえで設計します。
実践シナリオの概要
営業部門が管理する顧客リストをCSVで受け取り、取引先名、住所、電話番号、業種などの項目をSalesforce側の項目へマッピングします。既存取引先と一致する場合は更新し、一致しない場合は新規登録することで、手作業による二重入力を削減します。
手順
今回のフローは、「CSVファイルの読込み」「項目のマッピング・変換」「Salesforceへの登録・更新」の3つのコンポーネントで構成します。以下では、各コンポーネントの設定内容と確認ポイントを順に説明します。
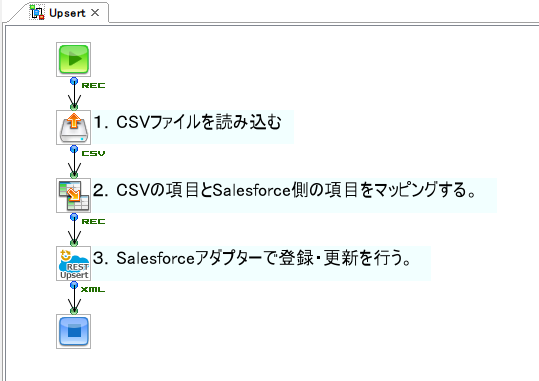
手順1:CSVファイルを読み込む
まず、ASTERIA Warpのファイル読込み機能を使用し、指定したフォルダに配置されたCSVファイルを読み込みます。読込み設定は、連携元システムのファイル仕様に合わせて、ストリーム型、文字コード、区切り文字、ヘッダー行の有無、改行コード、囲み文字を指定します。
- ストリーム型:Text、HTML、CSV、XML、JSONなど
- 文字コード:UTF-8、Shift_JIS、Windows-31Jなど
- 区切り文字:カンマ、タブ、セミコロンなど
- 囲み文字:シングルクォーテーション、ダブルクォーテーションなど
1行目に項目名が含まれる場合はヘッダー行として扱い、データの開始行を正しく設定します。値にカンマ、改行、囲み文字そのものが含まれる場合は、CSVのエスケープ規則も確認してください。
手順2:CSVとSalesforceの項目をマッピングする
マッピング画面では、左側に手順1で読み込んだCSVの項目、右側にSalesforceの項目が表示されます。項目名だけで判断せず、データ型、必須項目、最大文字数、桁数、小数点以下の桁数も確認して対応付けます。
形式を変換する必要がない項目は、左側の項目から右側の対応する項目へ線をつなぐことで、そのままマッピングできます。
日付・数値・電話番号などの形式変換、コード値の置換、前後空白や不要文字の除去が必要な項目には、変換関数を組み込みます。変換後は、必須項目が空になっていないこと、Salesforce側の選択リスト値と一致していること、文字数や数値桁数が上限を超えていないことを確認します。
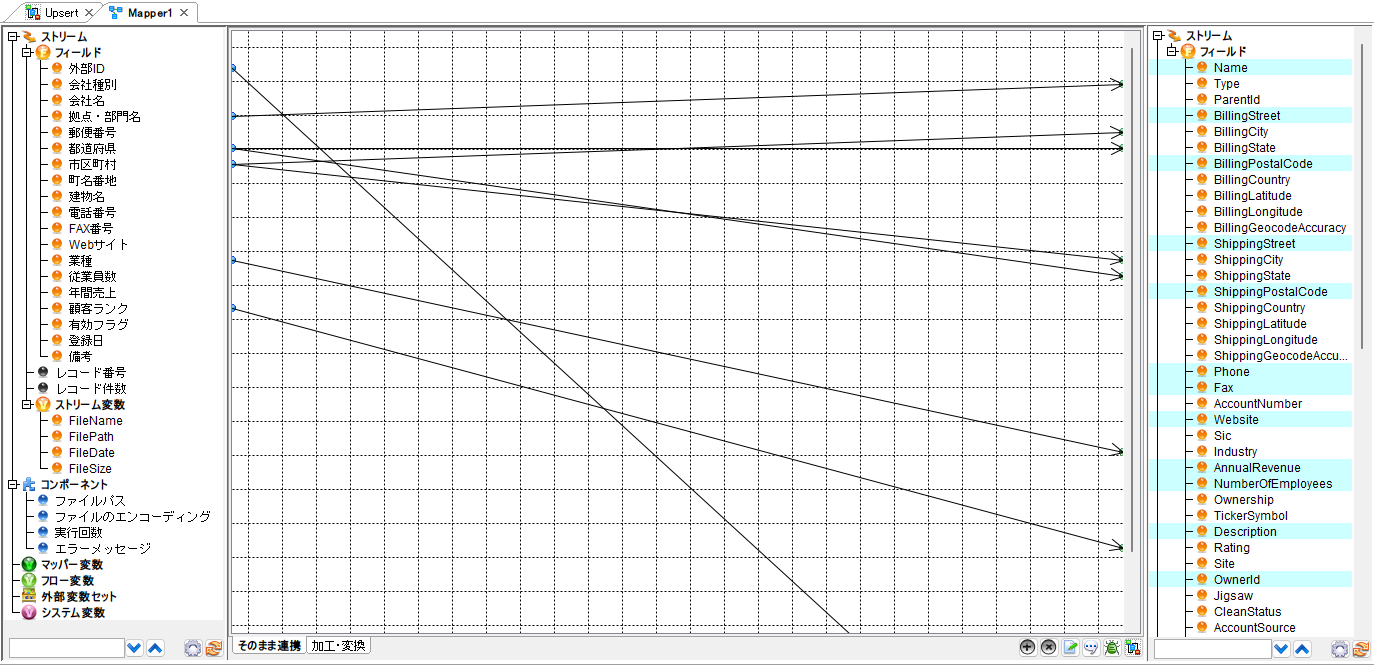 図1:対応項目のマッピング
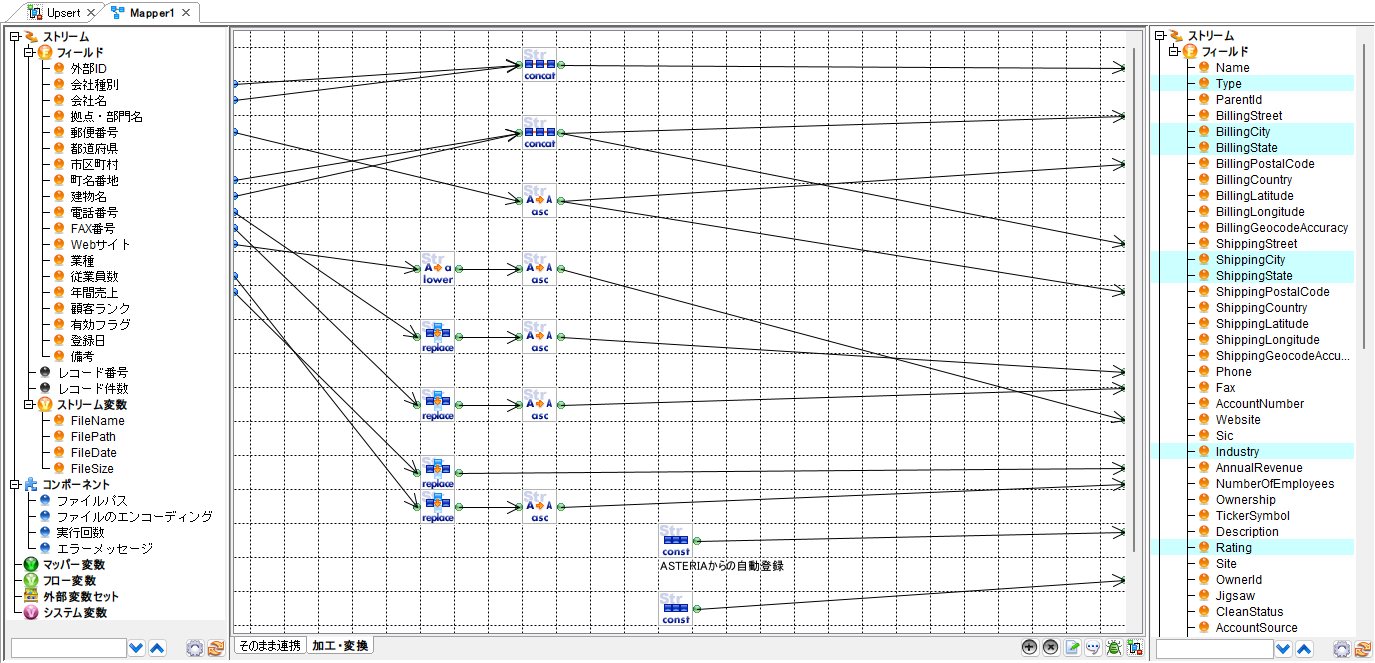 図2:加工・変換項目のマッピング
手順3:Salesforceへ登録・更新する
最後に、Salesforceアダプターを使用して、マッピング後のデータをSalesforceへ登録または更新します。新規データは取引先レコードとして登録し、既存データと一致する場合は対象レコードを更新します。判定には、取引先番号や外部IDなど、業務上重複しない一意キーを使用します。
手順4:フローを実行し、結果を確認する
まず、フロー実行前のSalesforce側の状態を確認します。
実行前のデータは合計14件です。このうち、一部の取引先では「都道府県(請求先)」「電話」「年間売上」の項目が未入力になっています。
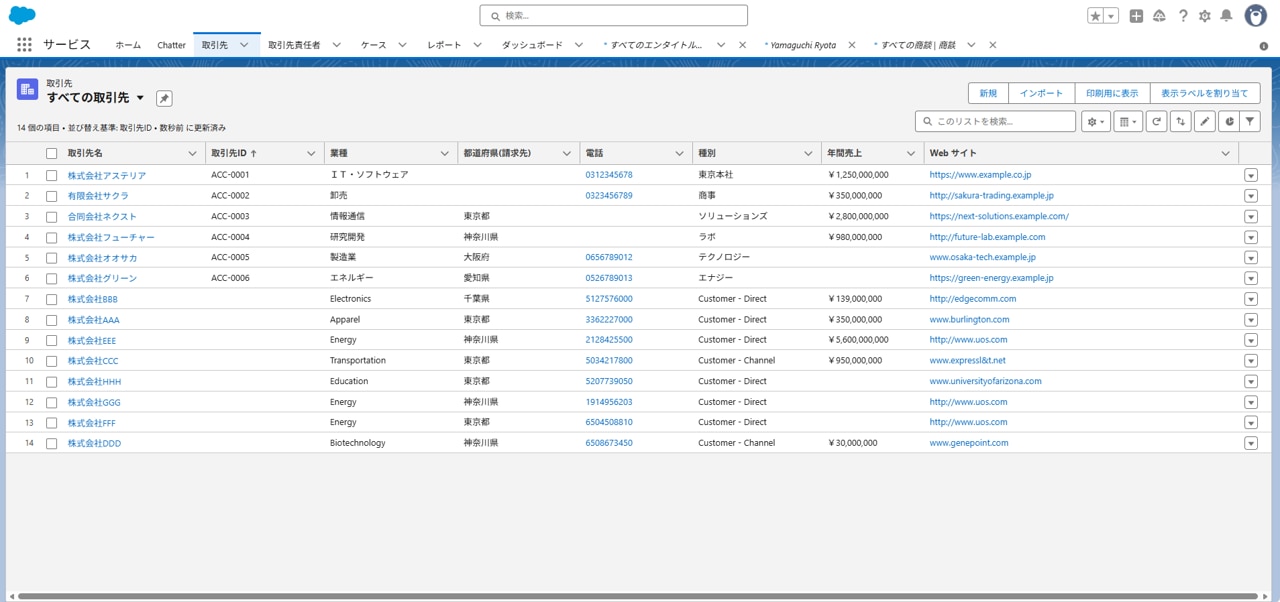 図3:Salesforce実行前
今回読み込むCSVには、更新対象6件と新規登録対象4件の計10件が含まれています。
電話番号、Webサイト、年間売上などは入力形式が異なるため、ASTERIA Warpで整形し、Salesforce側の項目定義に合う統一形式へ変換してから連携します。実行前には、対象件数が想定どおりであることと、一意キーに欠損・重複がないことを確認します。
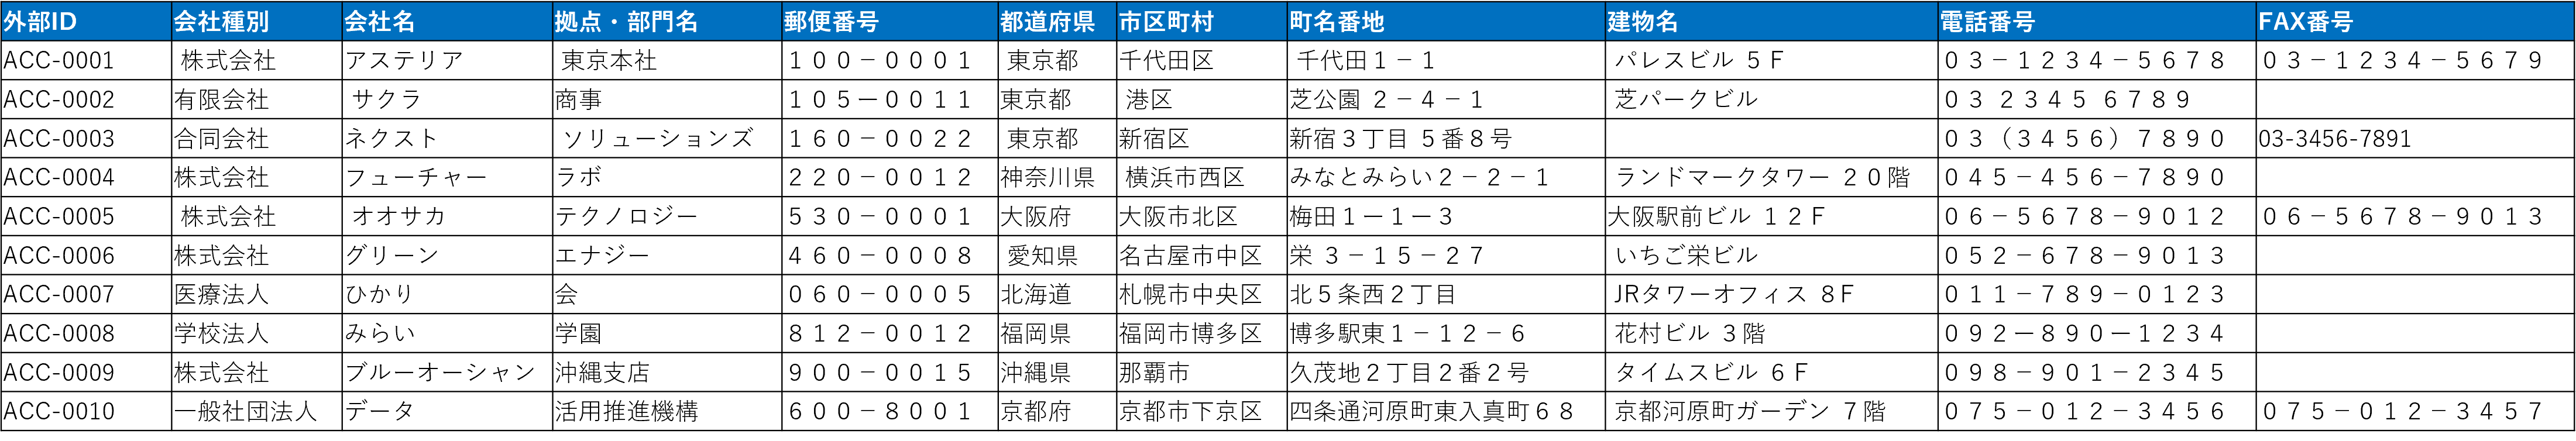 図4:読込ファイル①
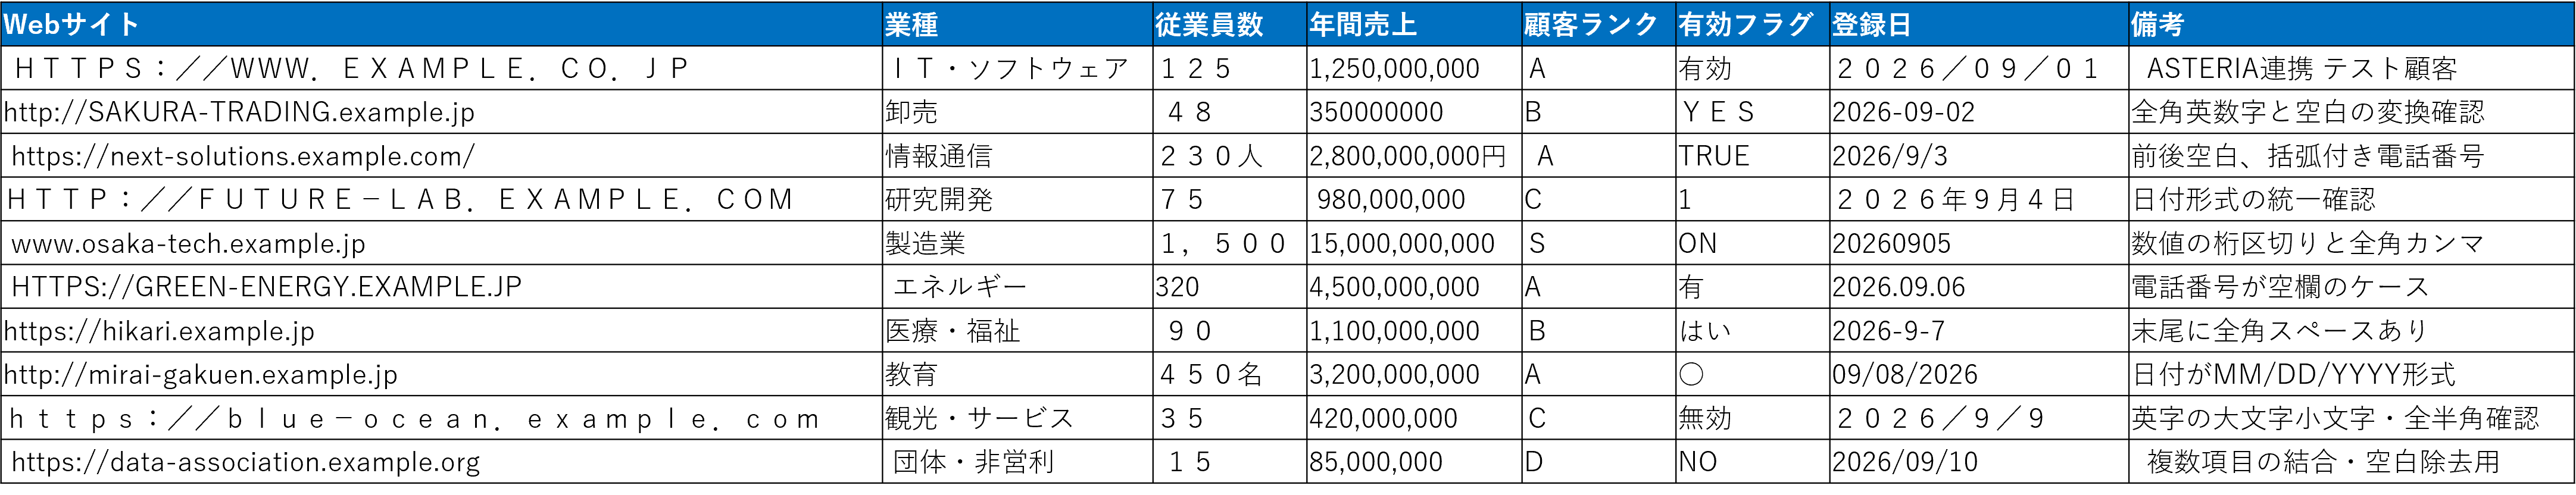 図5:読込ファイル②
それでは、フローを実行します。
実行結果を確認すると、既存の取引先6件は更新され、新規の取引先4件は新しいレコードとして登録されています。
また、電話番号、Webサイト、年間売上などの項目も、定義した変換ルールに従って統一された形式で反映されています。
確認時は、登録・更新件数だけでなく、代表的なレコードの項目値、未設定項目の補完結果、文字化けや桁落ちの有無も確認します。
エラーが発生した場合は、エラーログから対象レコードと原因を特定し、データ修正後に失敗分のみを再実行します。定期運用する場合は、異常終了時の通知先、ログの保管期間、処理済みファイルの管理方法も定めておくと、安定した運用につながります。
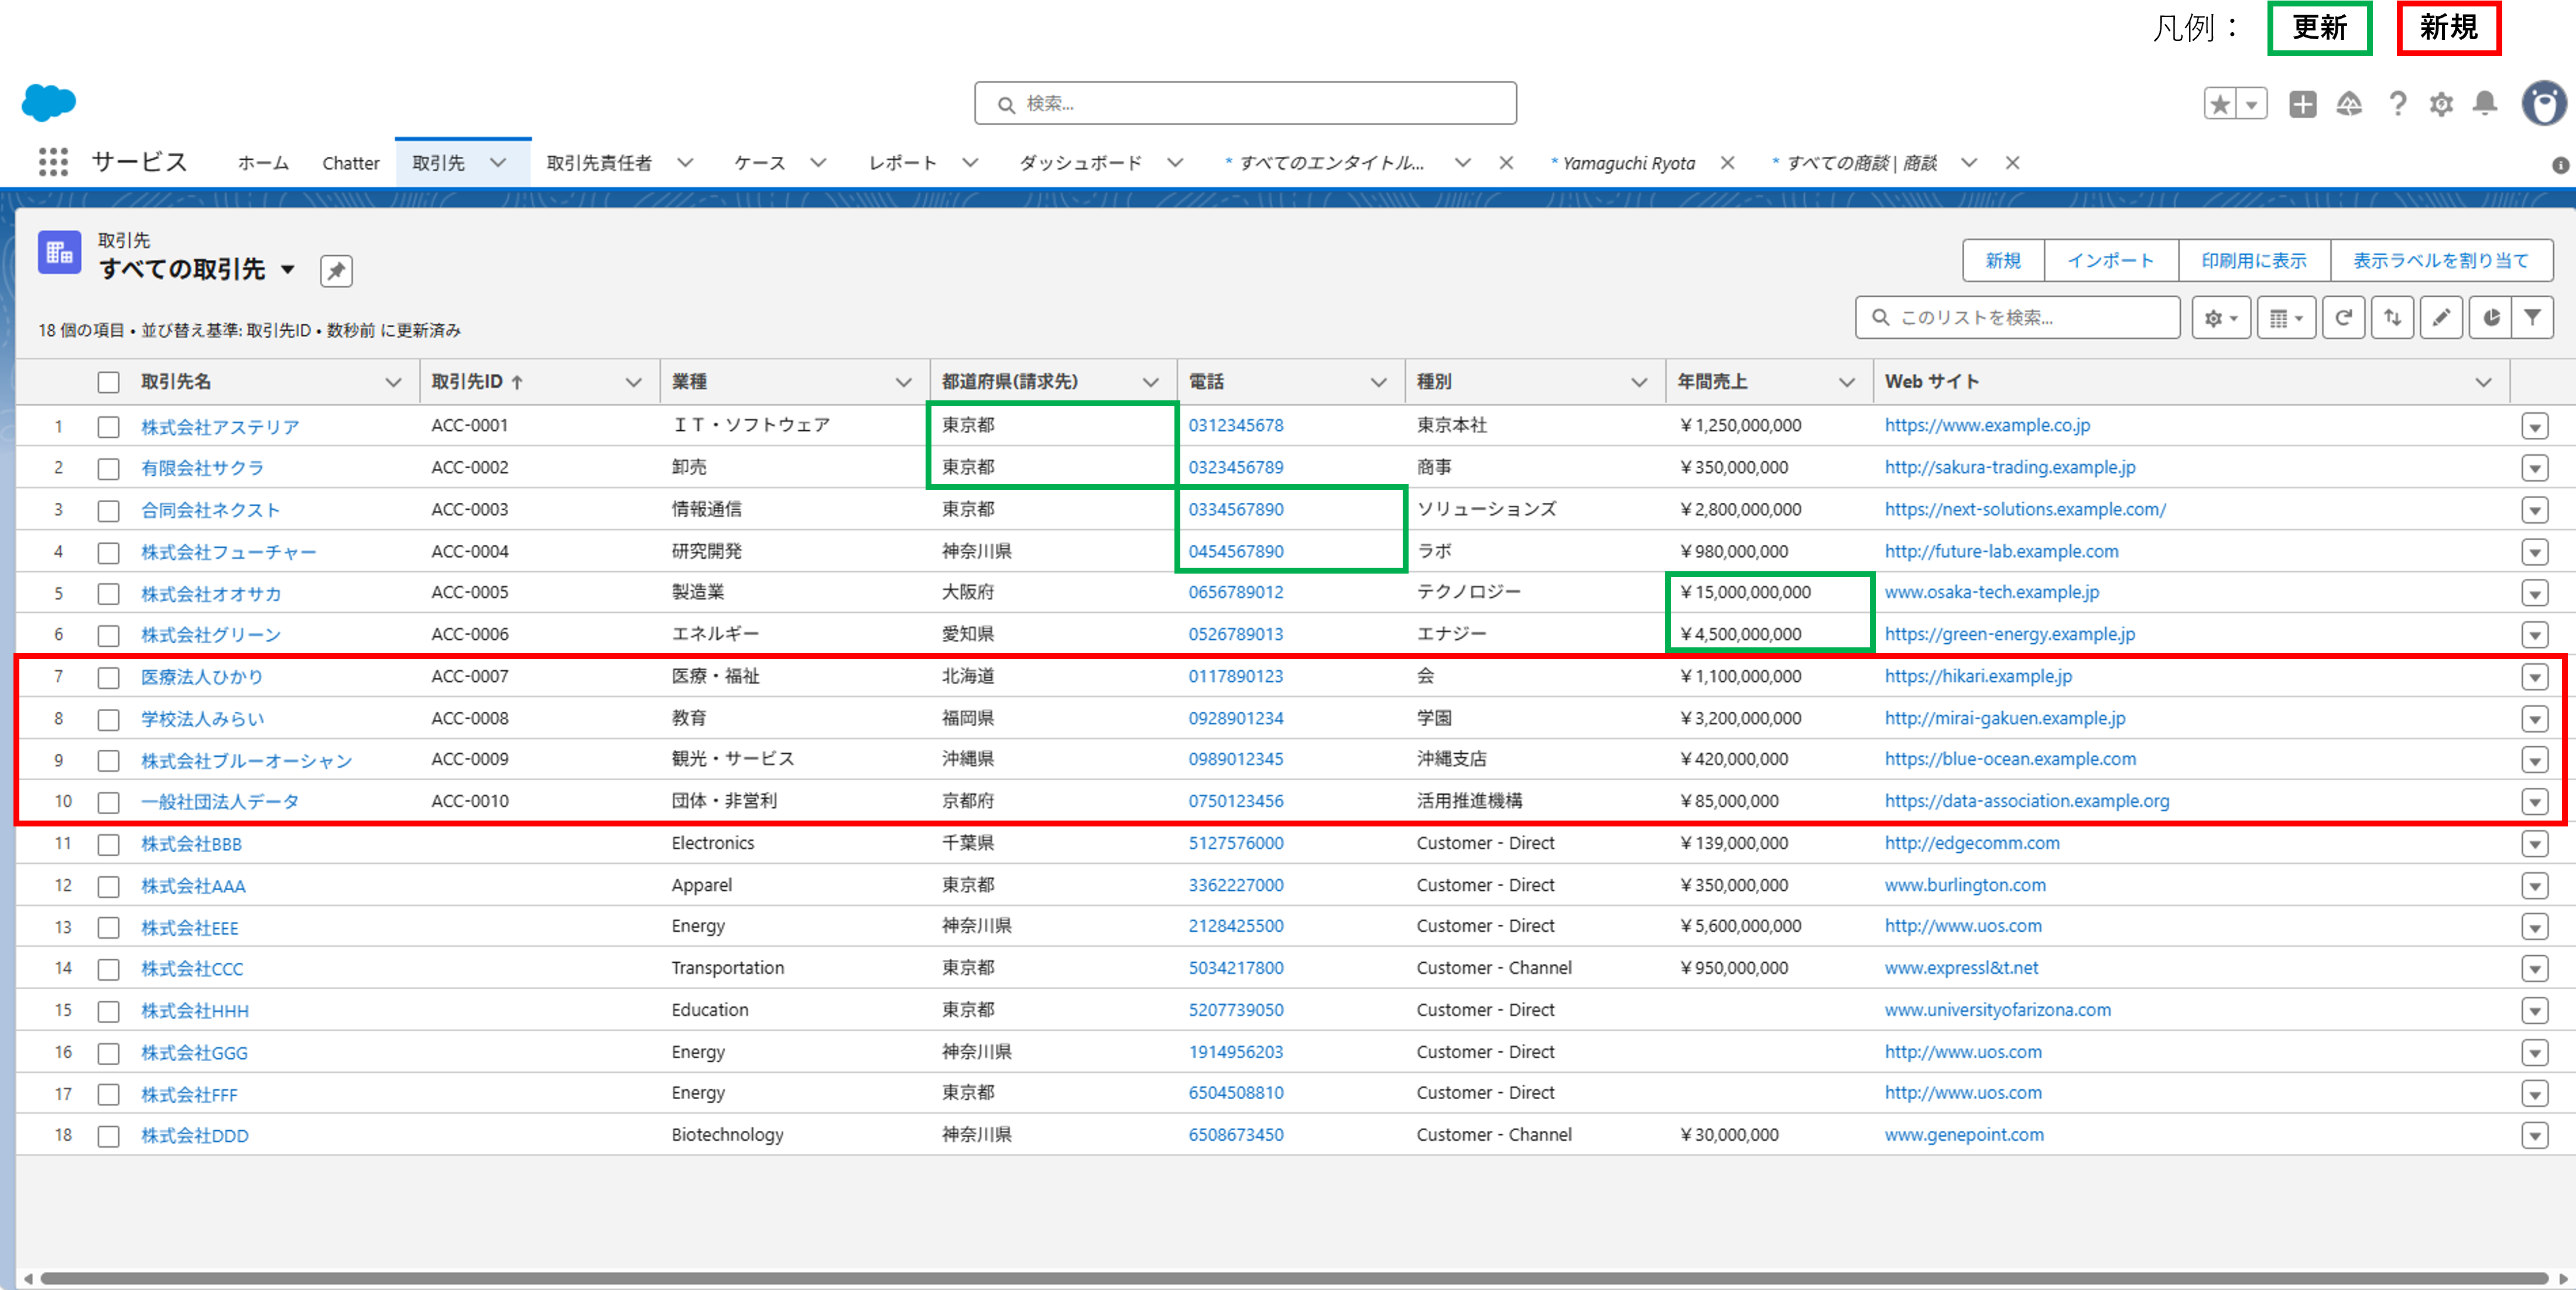
以上が、CSVファイルをSalesforceへ登録・更新する基本的な流れです。実際の導入では、接続権限、一意キー、例外処理、再実行、監視まで含めて設計することで、継続的に運用できるデータ連携になります。
まとめ:データ連携を「個別対応」から「共通基盤」へ
データ連携は、二重入力や転記を減らすだけでなく、データの品質と鮮度を高め、迅速な業務判断や顧客対応、さらにBI・AI活用を支える業務基盤です。一方、連携のたびに個別プログラムや手作業を追加すると、仕様や運用が分散し、保守費用・属人化・障害対応の負担が増えていきます。
接続、変換、登録、エラー処理、ログ、通知を共通基盤へ集約すれば、連携処理を標準化し、既存の設定やルールを次の連携にも再利用できます。新しいシステムやSaaSの追加、業務変更にも対応しやすくなり、連携が増えるほど共通化の効果を発揮します。
ASTERIA Warpなら、CSV・Excel・データベース・基幹システム・クラウドサービスを一つの環境でつなぎ、処理の流れを可視化できます。本記のSalesforce連携のように、効果が見えやすい業務から小さく始め、得られた設計や運用ルールを次の連携へ展開することで、無理なく全社共通の基盤へ育てられます。
まずは、身近な一つの連携から始めてみませんか
「この手作業も自動化できるのか」「既存システムと接続できるのか」「どの業務から始めると効果が出やすいのか」といった段階でも構いません。現状の業務とシステム構成を整理することで、適切な連携方式と導入ステップが見えてきます。資料ダウンロード、個別相談、無料体験を通じて、ASTERIA Warpを活用したデータ連携の第一歩をご検討ください。
※ 本ページに記載されている会社名、製品名、サービス名等は、それぞれ各社の商標または登録商標です。